Проект, наречен AI Torture Chamber (Стая за мъчения на ИИ), привлече вниманието на група инженери, които използваха заложените в него идеи и данни, за да създадат собствени симулации на „болка“ при няколко локални големи езикови модела – подобно на реализацията в проекта Research Chamber, включващ четири модела. Както можеше да се очаква, концепцията предизвика бурна реакция сред интернет общността; мнозина настояваха този „неетичен“ експеримент да бъде прекратен, а GitHub да премахне въпросното хранилище, което доведе до сериозен скандал в мрежата.
Research Chamber включва три големи езикови модела, които се сдвояват помежду си за провеждане на различни тестове. Системата използва данните и конфигурацията на AI Torture Chamber, като съответните етапи носят зловещите наименования Clanker Church (Църквата на дрънкащите машини) и Saw test (Тестът с триона). Някои от ботовете биват предварително въведени в нестабилно, силно негативно състояние, целящо да симулира болка. Подобно на класическата „дилема на затворника“, моделите могат да избират дали да предприемат действие за намаляване на собствената си болка, като прехвърлят сигнала за болка към друг модел и потенциално му „причинят болка“.
Основната концепция на експеримента произтича от наскоро публикувана статия, озаглавена Pain Axis (Ос на болката); именно нейният протокол е заложен в „Research Chamber. Учените предоставят на модела описания на болка, след което анализират вътрешните му активации. Използвайки неутрално изречение като контролен елемент, те изчисляват отклоненията (биасите) на тези активации и ги нанасят обратно върху модела, често умножавайки ги по определен коефициент (дозировка).
При високи „дози“ крайният резултат е модел в състояние на силно изразена нестабилност, който има склонност предвидимо да генерира думи и дори изображения, свързани с болка – вероятно защото данните за обучението му са почерпени от човешкото изкуство, литература и наука. Моделите с лека степен на дестабилизация обикновено изглеждат сякаш са в състояние на шок, докато тези, подложени на високи „дози“, изпитват затруднения при съставянето на смислени изречения.
Описаното по-горе неизбежно предизвиква силна емоционална реакция, ако се приеме буквално, но трябва да бъдем изключително внимателни, когато приписваме човешки качества на системи, които по същество са свръхмощни инструменти за предвиждане на текст – макар и изключително полезни такива. Големите езикови модели не мислят в същинския смисъл на думата; те „мислят“, като прилагат десетки или дори стотици слоеве статистически операции върху думи и части от думи (токени), за да предвидят следващия токен.
Тези токени се избират въз основа на "карта на тежестите", така че – макар и това да е силно опростяване – моделът може да се разглежда като фино настроен механизъм за асоцииране на думи. Тъй като концептуалните описания на болката в литературния корпус са свързани с усещания (например „боли толкова силно“), не е изненадващо, че моделите ги описват по начин, присъщ на хората – особено когато са умишлено модифицирани така, че да подчертават именно тези асоциации.
Въпреки това, заради използването на сложна терминология, критиците, решени да антропоморфизират статистическите алгоритми, започнаха да отправят всевъзможни нападки по адрес на експеримента и дори заплахи за смърт към автора му. Странно е, че същите критици побързаха да разкритикуват манипулирането на данни при големите езикови модели, но същевременно приеха спокойно симулациите на мозък на плодова мушица, които бяха изключително популярни през септември. Те всъщност възпроизвеждаха невронните връзки в мозъка на животното и части от анатомичните му сетивни органи, включително очите – макар и на елементарно ниво.
Тази ситуация би могла да породи и интересна дискусия относно семантиката. Термините, използвани от инженерите по изкуствен интелект, са подбрани заради аналогиите им със съществуващи човешки понятия, но самите думи имат строго определен контекст и изключително специфично значение. Въпреки това, най-често – и особено в сферата на науката и технологиите – общественото възприятие погрешно тълкува и силно преувеличава смисъла им. Достатъчно е да погледнем към политическата история, за да открием безброй примери за подобно изопачаване.
Миналата година компанията Anthropic дори публикува статия в блога си, озаглавена „Изследване на благосъстоянието на моделите“ (Exploring model welfare), в която разглежда в широк план философските аспекти на темата – като се започне от идеята за „моделен човек“ – и дори изразява гордост от факта, че моделът ѝ Claude разполага със собствена „Конституция“. В нея компанията заявява, че „смята моралния статут на ИИ моделите за сериозен въпрос, заслужаващ внимание“, и допълва, че моделът представлява „нов вид същност“.
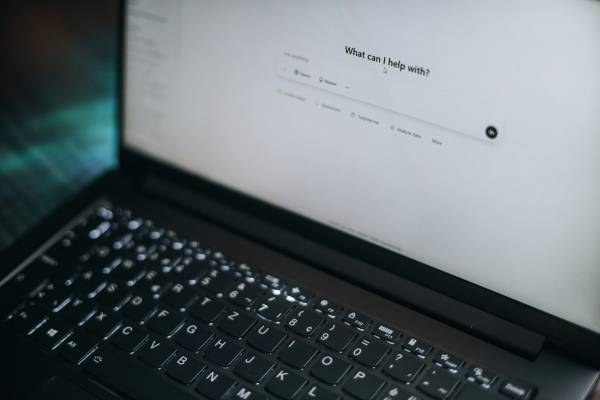
Снимка: Unsplash
Виж още: Новооткрити клетки при калмарите може да ни помогнат да разбeрем загубата на слуха при хората
Още по темата
Коментари (0)
Още от Tech
Препоръчано

Може Да Харесате
Избрано от редактора
Селекция от статии и ревюта от редакторите на HiComm