
В продължение на близо три десетилетия компютрите последователно преодоляват големите предизвикателства в игрите, в които хората традиционно доминират. През 1997 г. системата Deep Blue на IBM победи световния шампион по шахмат Гари Каспаров. През 2016 г. AlphaGo надигра майстора на играта „Го“ Ли Седол. Скоро след това дойде ред и на покера, тъй като системите с изкуствен интелект се научиха не само да изчисляват вероятности, но и да блъфират срещу елитни професионалисти.
Играта Stratego се оказа много по-трудна. Всеки играч командва 40 фигури, чиято самоличност е скрита от противника, а самата игра може да продължи стотици или дори хиляди ходове. За победата е необходимо нещо повече от това просто да се предвиждат ходовете напред. Играчите трябва да отгатнат какво крие противникът, да решат кога да блъфират и да преценят дали една на пръв поглед опасна фигура всъщност не се представя за такава, каквато не е.
Сега изследователи съобщават, че изкуствен интелект най-накрая е надделял над най-добрите хора в тази игра. Система, наречена Ataraxos, победи Пим Нимейер – четирикратен световен шампион и един от най-успешните играчи на Stratego – с резултат 15 победи срещу една загуба и четири равенства. Този резултат, описан в ново проучване в списание Nature, бележи постижение, което изследователите определят като първата демонстрация на игра на Stratego на свръхчовешко ниво.
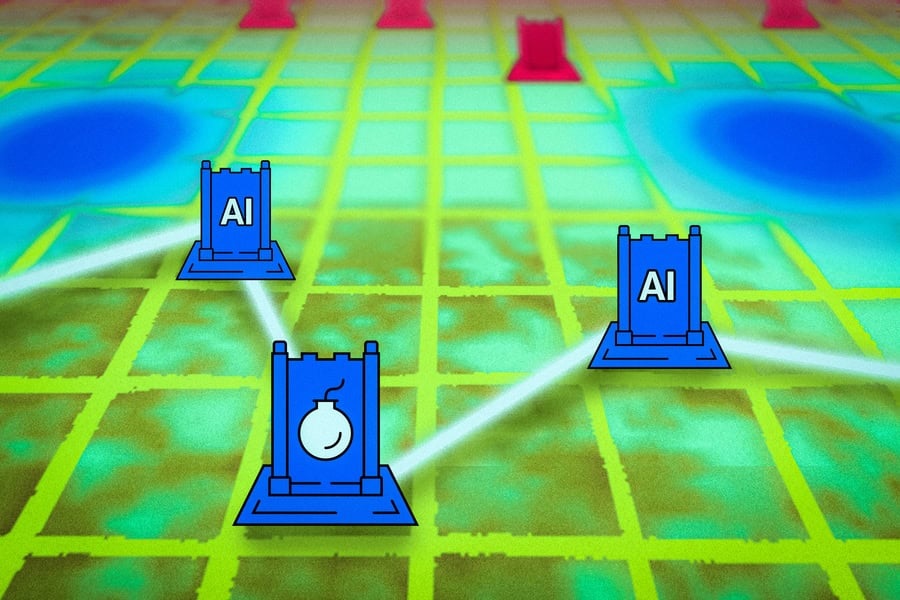
„Има нещо изключително характерно за Stratego: играта включва огромно количество скрита информация, която се разкрива в течение на много дълъг период от време“, заявява Юджийн Виницки, съавтор на изследването от Нюйоркския университет.
Именно тази скрита информация е същината на проблема. Играчите знаят къде се намират фигурите на противника, но не знаят какви са те, докато сблъсъкът не ги разкрие. Stratego предлага над 10³³ (число с 33 нули) възможни начални разположения. И за разлика от шаха, стойността на даден ход може да зависи от това какво според противника бихте могли да направите – както и от това колко често сте блъфирали преди.
Ataraxos започва работа подобно на други системи с изкуствен интелект за игри: учи се, като играе срещу себе си отново и отново. В хода на 163 милиона изиграни партии системата разработва базова стратегия за подреждане и местене на фигурите си. Изследователите обаче променят и начина, по който тя коригира стратегията си по време на обучението – като прави по-мащабни промени в началото и по-предпазливи на по-късен етап. Това помага да се избегнат нестабилни цикли на обучение, каквито могат да възникнат, когато нито един от играчите не разполага с пълна информация за състоянието на играта.
Ключовият елемент се проявява по време на самата игра. Преди всеки ход втора невронна мрежа прави предположения за това какви биха могли да бъдат скритите фигури на противника. Ataraxos разглежда множество възможни сценарии, симулира потенциални ходове и след това коригира избора си, преди да предприеме действие.
Важният напредък се състои не просто във възможността на Ataraxos да си представя бъдещи развои на играта, а в това, че успява да го прави, без да бъде „залят“ от огромната несигурност, присъща на Stratego. По-ранни системи, като DeepNash на DeepMind, до голяма степен избягваха този подход на предвиждане на ходовете, тъй като броят на възможните състояния на скритата дъска нараства главоломно бързо.
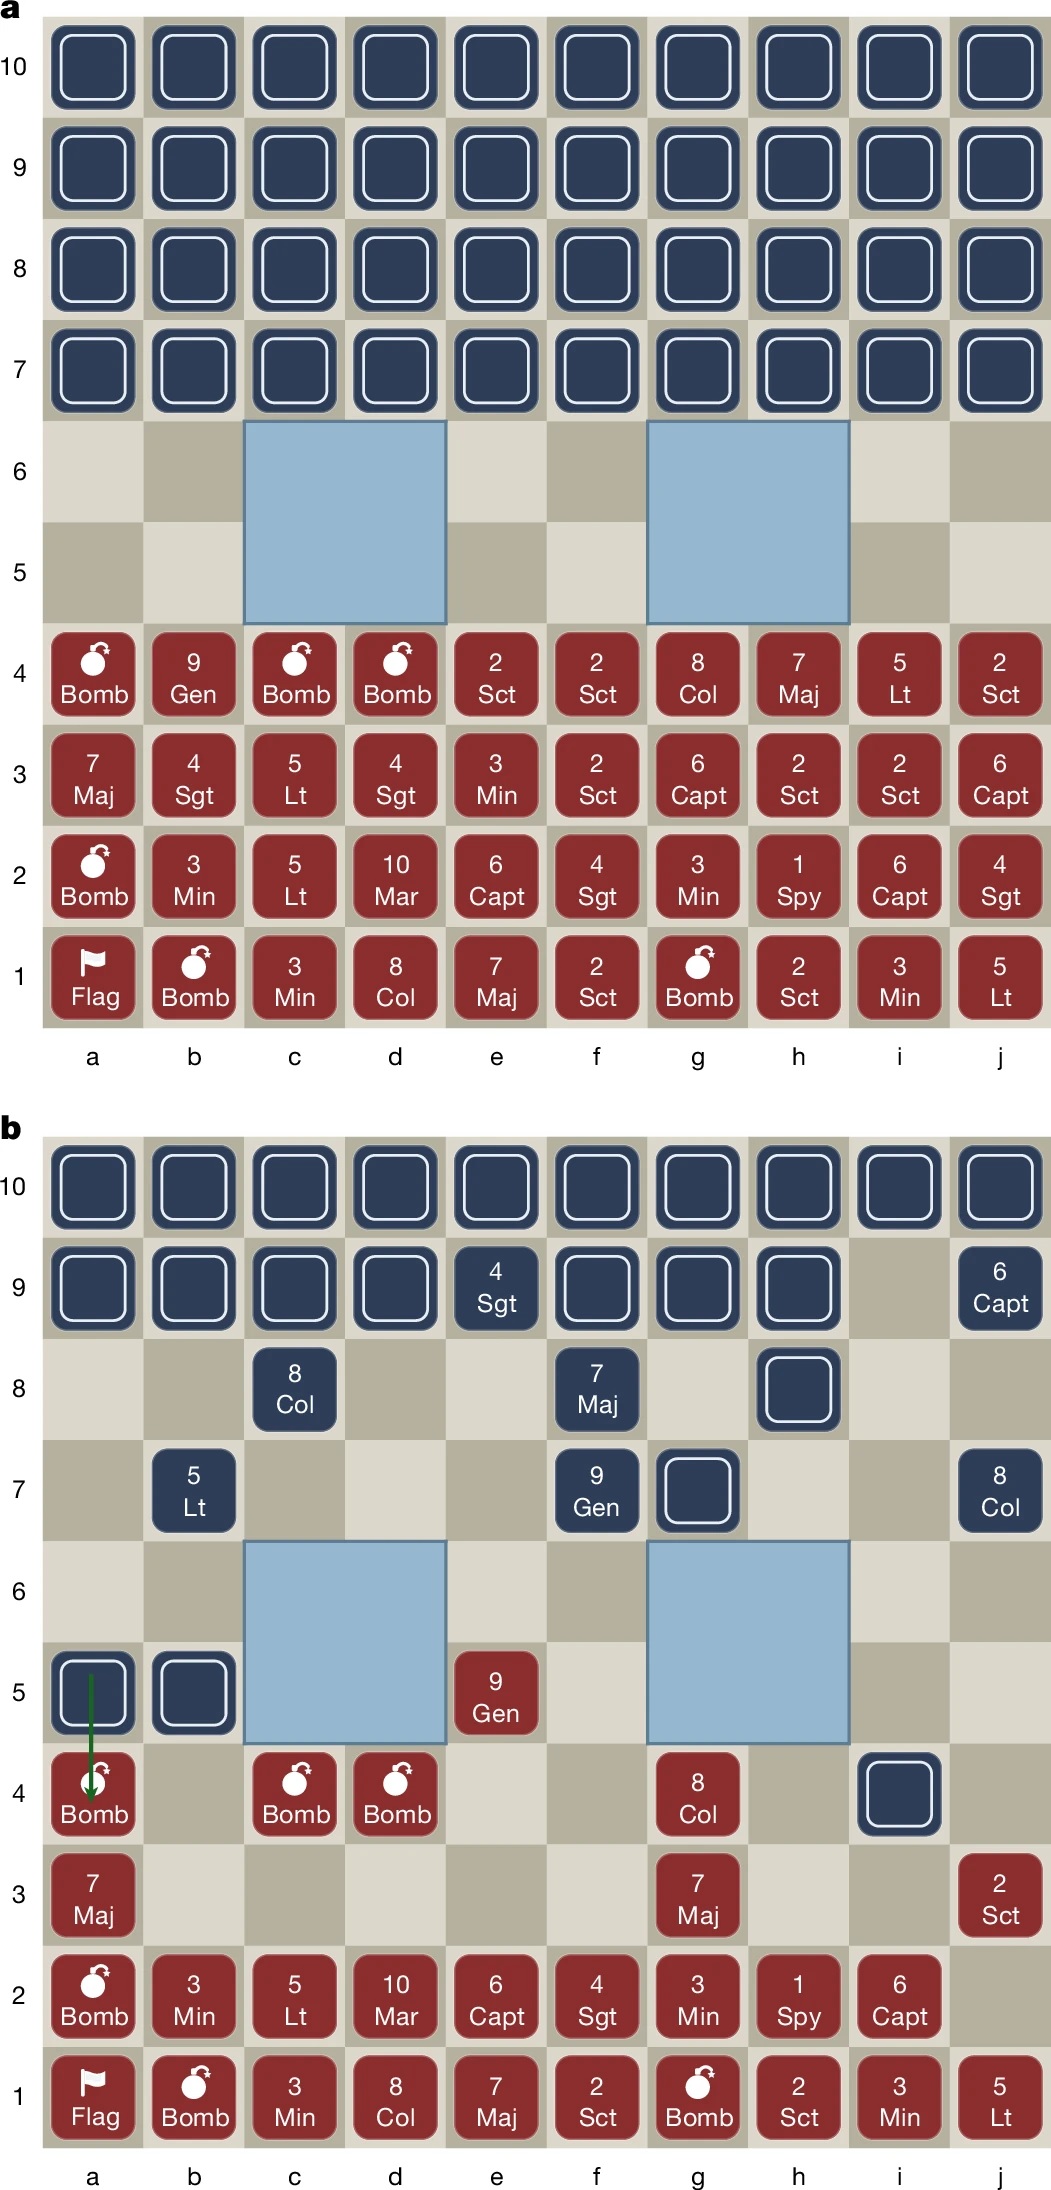
Ataraxos прави този процес управляем, като ограничава изчисленията си до сценарии, които вече счита за вероятни. Това му позволява да оцени няколко възможни продължения, преди да предприеме ход, вместо да разчита единствено на общата стратегия, усвоена по време на обучението.
Резултатът може да изглежда смущаващо спокоен. „За хората е много трудно, когато знаят някаква тайна, да вземат решения, пренебрегвайки факта, че я знаят“, сподели Габриеле Фарина от MIT пред Ars Technica. „За машините това е лесно.“
На Световното първенство по Stratego през 2025 г. Ataraxos спечели и 38 от 40 демонстрационни партии срещу присъстващи. Същият общ подход доведе до отлични резултати в Barrage Stratego, кооперативната игра с карти Hanabi и китайската игра с карти Dou Dizhu.
Постигнатата ефективност може да се окаже също толкова важна, колкото и победата над човек – шампион в играта. Основният етап на обучение чрез подсилване е използвал 16 графични процесора Nvidia H100 в продължение на една седмица, а моделът за оценка на вероятностите е задействал четири такива процесора за още четири дни. Според оценките на авторите, за този процес е била необходима едва една петстотна част от изчислителния ресурс, използван за обучението на DeepNash, както и около тридесет пъти по-малък брой партии, изиграни срещу самия себе си.
Преди това системата Libratus победи водещи професионалисти в покера в състезание от 120 000 ръце, демонстрирайки, че изкуственият интелект може да овладее дори игри, включващи скрита информация. Ataraxos пренася тази концепция в среда, в която обхватът на скритото състояние е значително по-голям.
Ataraxos демонстрира, че изкуственият интелект може да постигне значително по-добри резултати при разсъждаване в условия на несигурност в рамките на контролирана среда. Дали обаче това умение може безопасно да се пренесе извън пределите на игралното поле, е много по-сложен въпрос. Преговорите, киберсигурността и военното планиране са несравнимо по-сложни от една настолна игра – те включват променящи се правила, непълни модели и последици, които не могат просто да се сведат до победа или загуба.
В самата статия се посочва, че този подход е най-обещаващ за проблеми, при които изследователите могат да създадат бързи и точни симулатори.
Снимка: Unsplash/ Jose-Luis Olivares, MIT/Nature
Виж още: Тези странни нови уебсайтове са създадени специално за да стимулират допамина в мозъка ви
Още по темата
Коментари (0)
Още от HiEnd
Препоръчано

Може Да Харесате
Избрано от редактора
Селекция от статии и ревюта от редакторите на HiComm